论文:I Can Hear You: Selective Robust Training for Deepfake Audio Detection
作者:Zirui Zhang、Wei Hao、Aroon Sankoh、William Lin、Emanuel Mendiola-Ortiz、Junfeng Yang、Chengzhi Mao
机构:Columbia University、Washington University in St. Louis、New York University、Pennsylvania State University、Rutgers University
版本:以 ICLR 2025 会议正式版为准;早期预印本 arXiv:2411.00121v1,2024-10-31
发表记录:ICLR 2025
中文原创解读,2026 年 10 月 20 日发布;数值据原论文整理,未独立复现实验。封面使用原论文图;正文结果图按注明来源的数值重绘。
音频检测器和人类听众可能在“听”完全不同的东西。人类注意内容、音色与韵律,模型却可能利用某些高频统计线索判断真假。这样的线索有识别价值,也可能很脆弱:小幅变化就能改变分类结果。
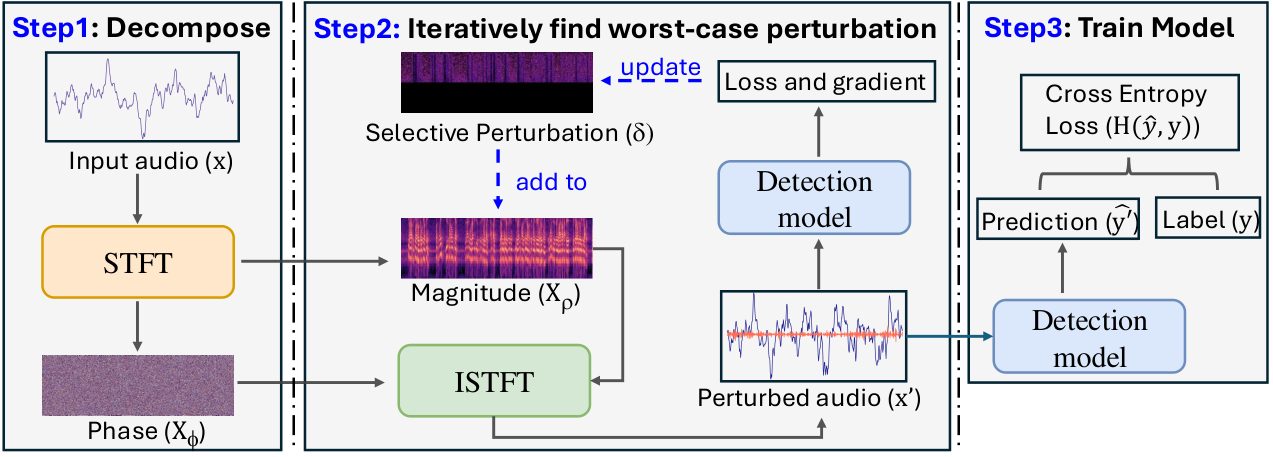
《I Can Hear You》提出的 F-SAT(Frequency-Selective Adversarial Training)并不是直接去掉高频。它选择在训练时专门扰动某个频带的幅度谱,让检测器学习在这些线索被干扰时仍保持判断,同时保留干净样本训练以控制性能损失。
版本说明:本文以 ICLR 2025 正式会议 PDF 为主要依据,arXiv:2411.00121v1 仅作早期版本对照。两版的表格、测试规模和部分结果不同,下面的核心数值统一来自正式版,不混用早期版本的宣传数字。
问题:高频线索有用,也容易受到干扰
作者先分析 RawNet3 的频率依赖:对输入作滤波或在不同频段施加攻击,观察真假检测准确率如何变化。实验显示,部分较高频带对该模型判断合成语音尤为重要。
这可以类比于检查照片是否经过生成:水印般的纹理线索可能很管用,但一旦压缩或后处理改变纹理,判据就会动摇。对语音而言,单纯追求干净数据上的最强分类线索,未必自然带来对扰动的稳健性。
不过,高频不等于人类听不见。论文常把高频线索描述为难以被人感知,但 4–8kHz 本身仍在许多人的可听范围内。是否能察觉具体扰动,还取决于幅度、掩蔽、音量、设备和听者,不能只凭“高频”两个字就认定绝对不可感知。
作者在正式版额外说明:低频特征虽然相对稳健,单独使用又不一定提供足够的检测信息。因此方案是保留并保护高频证据,而非用低通滤波把所有高频删掉。[正式版 §1、§5.5、图 2]
贡献之一:DeepFakeVox-HQ 扩大训练覆盖
方法之外,论文构建了 DeepFakeVox-HQ:约 130 万条训练语音,包含约 27 万条较高质量的合成样本。训练数据既有较新的语音生成系统,也混入已有语料,真实与合成音频都覆盖不同质量条件。正式版测试集约 6,000 条,真假大致平衡,包含训练未覆盖的生成来源与社交平台音频。
这意味着本文的改进有多个来源:训练语料、随机增强、选择性对抗训练。只比较最终模型与一个在旧数据上训练的模型,无法把全部收益归因于 F-SAT。真正用于分析组件贡献的,是同训练背景下的消融表。
“论文提出了一个公开数据集”也不自动等于“今天有可下载的完整数据和检查点”。本次未在所读正式论文中确认完整官方数据、训练实现与权重的一站式发布入口,因此下文只报告论文实验,不承诺拿到资源即可原样复现。
F-SAT 数据流:只让指定频带的幅度发生变化
设 x 是音频波形,y 是真实标签。先做短时傅里叶变换 STFT,把波形写成幅度 A 和相位 φ:
X = A · exp(jφ)
X′ = (A + M ⊙ δ) · exp(jφ)
x′ = ISTFT(X′)
这里 M 是只允许指定频带通过的掩码,δ 是待寻找的扰动。上式使用 ⊙ 表示逐元素掩蔽,是对论文矩阵掩码表达的等价结构示意。相位路径保持原值,扰动集中在幅度部分。
原始波形 x
  ↓ STFT
幅度 A ── 选定频带掩码 M + 对抗扰动 δ ──┐
相位 φ ───────── 保留 ───────────────────┤
                                          ↓ ISTFT
                                   扰动语音 x′
                                          ↓
检测器 + 原始标签 y → 损失 → 更新扰动 / 更新模型
内部找困难样本,外部训练检测器
内部步骤固定检测器,寻找让分类损失升高的扰动;外部步骤用这些困难音频和原始标签更新检测器。它与只生成几种随机噪声不同,因为扰动的方向来自当前模型的损失反馈。
训练还保留干净音频损失:
Ltotal = Lclean + γ · Lrobust
γ 控制鲁棒损失项的权重。它不是“每次训练中鲁棒损失与干净损失的实际数值比必定等于 γ”;两个损失在训练中会变化。原文使用的内层扰动范围、步数与外层训练配置也需要分开记录。
4–8kHz 是实验选择,不是通用常数
正式版比较 0–8、2–8、4–8 与 6–8kHz 的训练频段,4–8kHz 在其所测综合结果中较好。过宽的频带可能损害干净性能,过窄则留下其他攻击空间。但这不意味着任意采样率、信道、检测器都应直接套用 4–8kHz:频带上限受到采样率与实际传输带宽约束。[正式版 §4.1、§5.5、表 4]
RandAugment 与 F-SAT 各自处理什么
RandAugment 随机选择音频处理,例如噪声、滤波和失真,让训练覆盖多种常见变化。F-SAT 则针对当前模型的脆弱方向生成困难样本。两者分别扩大变化覆盖与强化对抗方向,并不是彼此替代。
论文还将无意损坏(corruption)与主动攻击分开评测。对 24 种损坏表现变好,并不自动证明对主动攻击同样鲁棒;同理,只防住一种固定频带攻击,也不代表对未知生成器、压缩链路或所有语义变化都稳健。
正式版消融:随机增强打底,F-SAT 主要强化攻击下表现
以下摘录正式版表 3 的 F1 列。保留 0–1 尺度与原文标签,不把它改称准确率;表中 F1 的具体平均方式未在此表说明,本文也不从两类准确率自行倒算替代。
| 训练方案 | 原始音频 | 损坏音频 | 时域攻击 | 频域攻击 |
|---|---|---|---|---|
| RawNet3 | 0.861 | 0.720 | 0.134 | 0.202 |
| + RandAug | 0.968 | 0.860 | 0.693 | 0.613 |
| + RandAug + 时域 AT | 0.891 | 0.818 | 0.211 | 0.207 |
| + RandAug + F-SAT | 0.974 | 0.885 | 0.910 | 0.924 |
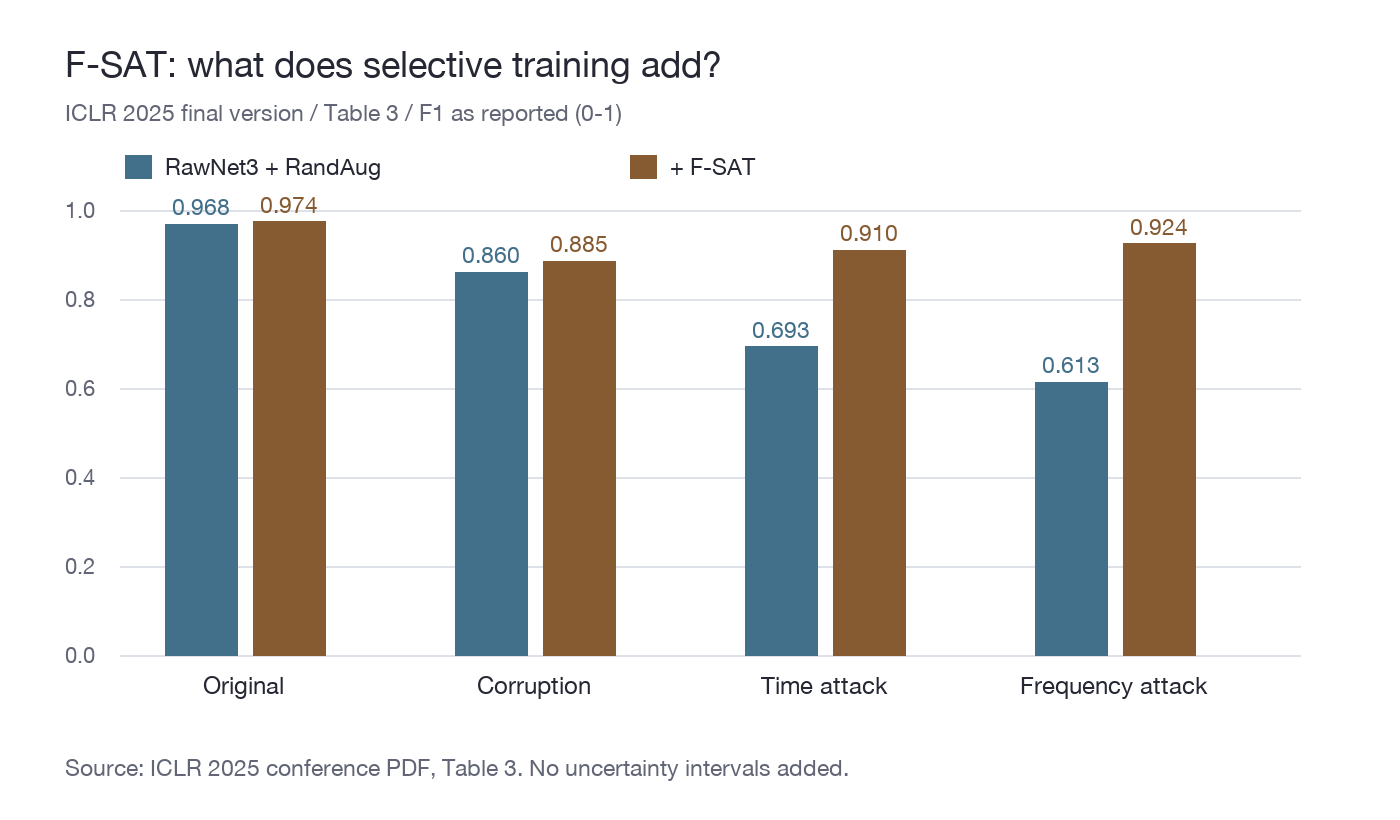
与仅 RandAug 相比,F-SAT 的原始音频 F1 增加 0.006,而时域攻击与频域攻击下分别增加 0.217 和 0.311。这个对照更清楚地体现选择性对抗训练的增益,不能把整套方法相对最弱基线的全部改进都归给一个组件。
时域 AT 配置相较于仅 RandAug 明显退化,这说明论文测试的这种训练设置不合适;不能由此推导出所有时域对抗训练在任何预算下都会失败。
版本与数值校注:正式版表 2 中 DeepFakeVox-HQ 的 RawNet3 与 Ours F1 为 0.861、0.974,差 0.113;但同版 §5.3 正文仍写“7.8% F1”提升,摘要又保留“7.7%”准确率说法。早期 arXiv 表格使用另一组值和 Avg 列。本文按正式版表格逐项报告,不将这些不一致数字拼接成统一结论。
攻击预算决定“鲁棒”这句话有多强
正式版 §5.4 的主结果使用两步 PGD:时域幅度限制 ε = 10−4,频域幅度限制 ε = 10−3,并对不同频带的攻击结果作汇总。时域与频域的 ε 作用在不同表示上,不能直接按数值大小比较实际音量。作者还用 SNR 评价扰动强度;高 SNR 支持扰动能量较小,但不能单独证明所有听者都不可感知。
附录表 6 加入五步和多次重启,以及同权重、不同权重和跨模型的攻击来源。结果显示,更强的白盒搜索仍会明显降低 F-SAT 的表现。例如全频域 0–8kHz、同权重来源 A 时,两步一次重启下真假准确率为 87.0% / 86.3%;五步两次重启下降到 63.7% / 69.2%。
这组附录结果很关键:它支持 F-SAT 比基线更稳健,同时提醒我们主表的高分依赖攻击预算。它不是形式化鲁棒保证,也不能替代更长迭代、更多重启与针对防御重新设计的自适应攻击。
训练配置也要分开:附录 A.8.1 给出的表 3 训练配置中 ε 为 0.005,γ 为 0.1,内层两步;正文图 7 在 10% 数据上的超参数分析讨论 ε = 0.01。二者实验目的不同,不能把其中一个值当成全篇所有实验的统一默认值。
局限、成本与研究启发
- 评测仍主要是数字音频实验。真实社交媒体来源增加了数据复杂性,但不等于完成了现场回放或电话链路中的自适应攻击验证。
- 主要方法以 RawNet3 为载体。对其他前端、预训练特征或大规模音频模型的适用性需要单独验证。
- 频率解释不是普遍听觉规律。幅度与相位的影响取决于模型和处理流程,不能认定相位对所有语音任务都不重要。
- 训练成本会上升。附录表 10 报告相同 15 个 epoch 条件下,无对抗训练、标准 AT 与 F-SAT 用时分别为 2、4.5、8 天,硬件列为 A100;这是作者配置下的记录,不是通用耗时估计。
- 可复现资源与论文结论分开。第三方重实现不能自动当作作者官方实现,更不能等同于原始数据和权重的发布。
解读观点:F-SAT 提供了一条有针对性的路线:先定位模型依赖的脆弱频段,再把该频段的不利变化加入训练,同时保留干净样本约束。但后续研究必须继续追问:优势能否抵御更强的自适应攻击,能否跨检测器保留,以及是否只是把依赖从一个脆弱线索迁移到了另一个线索。
原始资料与版本说明
- I Can Hear You: Selective Robust Training for Deepfake Audio Detection:主要解读版本。方法、表格与局限均以本文标明版本为准。
- 正式会议记录,用于核实发表信息。
- 早期 arXiv v1:仅作版本对照,不与正式版混用数值。
论文事实、作者解释与本文观点分别表述。图示为原理说明或已公开数值的重绘,不代表新增实验。
相关阅读
- FoeGlass:在 TTS 输入空间寻找检测器盲区
- Benign Samples Matter:100 个良性离群样本,为什么会破坏大模型安全对齐?
- 合成语音真能可靠检测吗?白盒、黑盒与迁移攻击揭示的边界
- P²V:从近满分到跨数据集失准,25 万条语音揭示检测盲区
这些文章讨论的权限、数据与指标不同,相关阅读用于理解问题之间的联系,不作成功率横向排名。