论文:Perturbed Public Voices (P²V): A Dataset for Robust Audio Deepfake Detection
作者:Chongyang Gao、Marco Postiglione、Isabel Gortner、Sarit Kraus、V. S. Subrahmanian
机构:Northwestern University、Bar-Ilan University
版本:arXiv:2508.10949v1,2025-08-13
发表记录:本文按 arXiv v1 解读;数据发布计划与已确认下载入口分别说明
中文原创解读,2026 年 10 月 20 日发布;数值据原论文整理,未独立复现实验。封面使用原论文图;正文结果图按注明来源的数值重绘。
一款检测器在熟悉的测试集上接近满分,换到带背景噪声、来自新合成器的音频,却可能大幅失准。P²V(Perturbed Public Voices)把这种落差做成一个可重复评测的问题:当说话内容、克隆技术和音频后处理一起变化时,现有检测器还能否泛化?
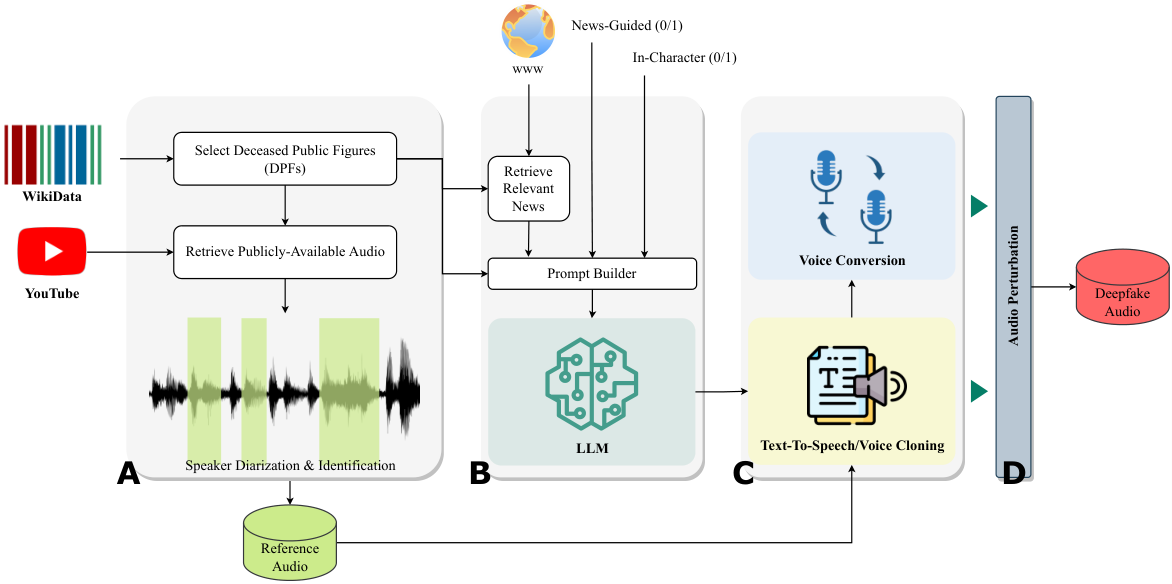
这篇工作提出的主要贡献是数据集与评测框架,而不是一种自动寻找最优扰动的攻击算法。它把公共人物语音、不同语言模型生成的台词、十种语音合成/转换流程和十种扰动纳入同一数据构造流程,帮助研究者定位跨数据集失效的来源。
为什么“在测试集上很准”仍然不够
语音检测器可能学到生成器、录音条件或压缩流程留下的线索。只要训练和测试共享这些线索,测试成绩可以很好;当用户上传的新音频经过不同处理,这些线索就可能失效。
P²V 试图同时改善三个维度:让台词在人物身份和语境上更可信;覆盖较新的 TTS 与声音转换技术;加入噪声、压缩、混响等变化。它的出发点不是宣称“噪声一定更难检测”,而是将这些变化显式纳入评测,因为不同处理可能让检测变难,也可能让检测更容易。
一个重要边界是:论文中的“adversarial perturbations”多数是预先指定、随机选取的后处理,并不依赖目标检测器的梯度或查询反馈。它们可以用来模拟或研究规避行为,但与 PGD、自适应黑盒搜索或 FoeGlass 的反馈搜索不是同一种威胁模型。
数据怎样构造:四个阶段各自控制什么
已故公众人物的公开参考语音
  ↓  说话人分离与目标片段提取
LLM 生成台词:新闻引导 / 非新闻引导,符合 / 不符合人物设定
  ↓
7 种 TTS + 3 种声音转换流程
  ↓
每段合成音频随机选择一种扰动,并记录类型与参数
  ↓
P²V[o] 原始版 / P²V[p] 扰动版 → 按人物划分评测
参考人物与台词
数据覆盖 206 位已故公众人物。作者从公开材料获取参考语音,并用说话人分离等处理提取目标人物的片段。论文报告通过 IRB 审查,但这不等于对任意后续声音克隆用途授予许可;数据使用仍需遵循最终发布条款。
台词由 Gemma-3 27B、Qwen2.5 14B 和 Mistral 24B 三个开源语言模型生成,包含人物设定和新闻引导的不同组合。因此不能把整个数据集描述为“所有台词都与人物身份完全一致”。设计中也有 out-of-character 条件,便于比较内容变化的影响。
十种生成流程,不是十种检测器
七种 TTS 包括 Tacotron DCA、YourTTS、XTTS、VEVO、Zonos、CosyVoice 2 和 IndexTTS。另三种流程使用 Diff-HierVC、FreeVC、Seed-VC,将 IndexTTS 生成的语音进一步转换。后一类是叠加的生成链路,不能简单当作完全独立的直接文本合成模型。
十类扰动,也不是每段都连续处理十次
扰动包含背景噪声、高斯噪声、空气吸收模拟、MP3 压缩、变调、带通滤波、时间伸缩、时间反转、脉冲响应卷积和削波失真。正文说明每段合成音频从中随机选择一种,并采样参数。这种设计不同于把所有操作叠加到每一段音频上。
有些操作模拟现实信道,有些更像压力测试。例如时间反转破坏正常语音的时间结构,不应自动被视为可用于自然交流的、听感不变的攻击。[原文“Perturbed Public Voices”方法部分、图 1]
规模与划分:257,440 条样本,类别高度不平衡
| 项目 | 训练 | 验证 | 测试 | 总计 |
|---|---|---|---|---|
| 人物 | 131 | 37 | 38 | 206 |
| 合成语音 | 157,200 | 44,400 | 45,600 | 247,200 |
| 真人语音 | 6,237 | 1,963 | 2,040 | 10,240 |
| 合计 | 163,437 | 46,363 | 47,640 | 257,440 |
按人物划分的意义是:同一个人物不能同时出现在 P²V 的训练与测试中,减少把人物身份记住当作判断真假依据的风险。但这不自动保证人物以外的所有关联因素——例如语料来源、处理链路和生成器——都完全独立。
合成语音占约 96%,与实际业务里真人语音常占多数的情况不同。因此单看整体准确率可能误导,应该同时检查两类的精确率、召回率以及部署环境中的假阳性代价。
v1 校注:统计段落有一处把总量写作 257,040,但表 1、引言和结论使用 257,440,且 247,200 + 10,240 = 257,440。本文按可加和的表 1 记录,不静默沿用不一致数字。
读懂 DDS:它不是准确率,也不是漏检率
作者用 22 个检测器配置开展评测,涉及 RawNet3 以及 LCNN、MesoNet、SpecRNet 等架构与不同特征的组合。它们不是 22 种彼此独立的模型架构。正文主结果由这些基线的预测取平均后计算,单个配置的细节放在附录;不能把集合预测的分数当作每一个模型的成绩。
论文定义 Deepfake Detection Score(DDS):
DDS = [F1fake + AUC + (1 − EER)] / 3
三项先以同一 0–1 尺度计算,再换算到 0–100 展示。表中的 EER 仍使用小数,例如 0.240 表示 24.0%;F1 与 AUC 则按百分尺度显示。若直接将这些展示值混算,会得到错误结果。
以表 2 基线为例:F1fake = 21.92,AUC = 84.54,EER = 0.240,那么 DDS = (21.92 + 84.54 + 76.0) / 3 = 60.82。它把固定阈值下的分类、排序质量和错误率工作点综合起来,适合概览,但会掩盖具体失败模式。
因此,DDS 60.82 不能写成“60.82% 的假音频被识别”。该基线表中的假音频召回率实际只有 12.31%,两者含义差别很大。[原文 Evaluation Metrics、表 2]
跨数据集结果:从 99.89 到 56.42 的落差
将模型在 In-the-wild(ITW)上训练、再换测试集,结果如下:
| 训练集 | 测试集 | DDS ↑,0–100 |
|---|---|---|
| ITW | ITW | 99.89 |
| ITW | P²V[o] | 56.42 |
| ITW | P²V[p] | 60.82 |
| P²V[p] | ITW | 84.42 |
| P²V[o] | ITW | 88.96 |
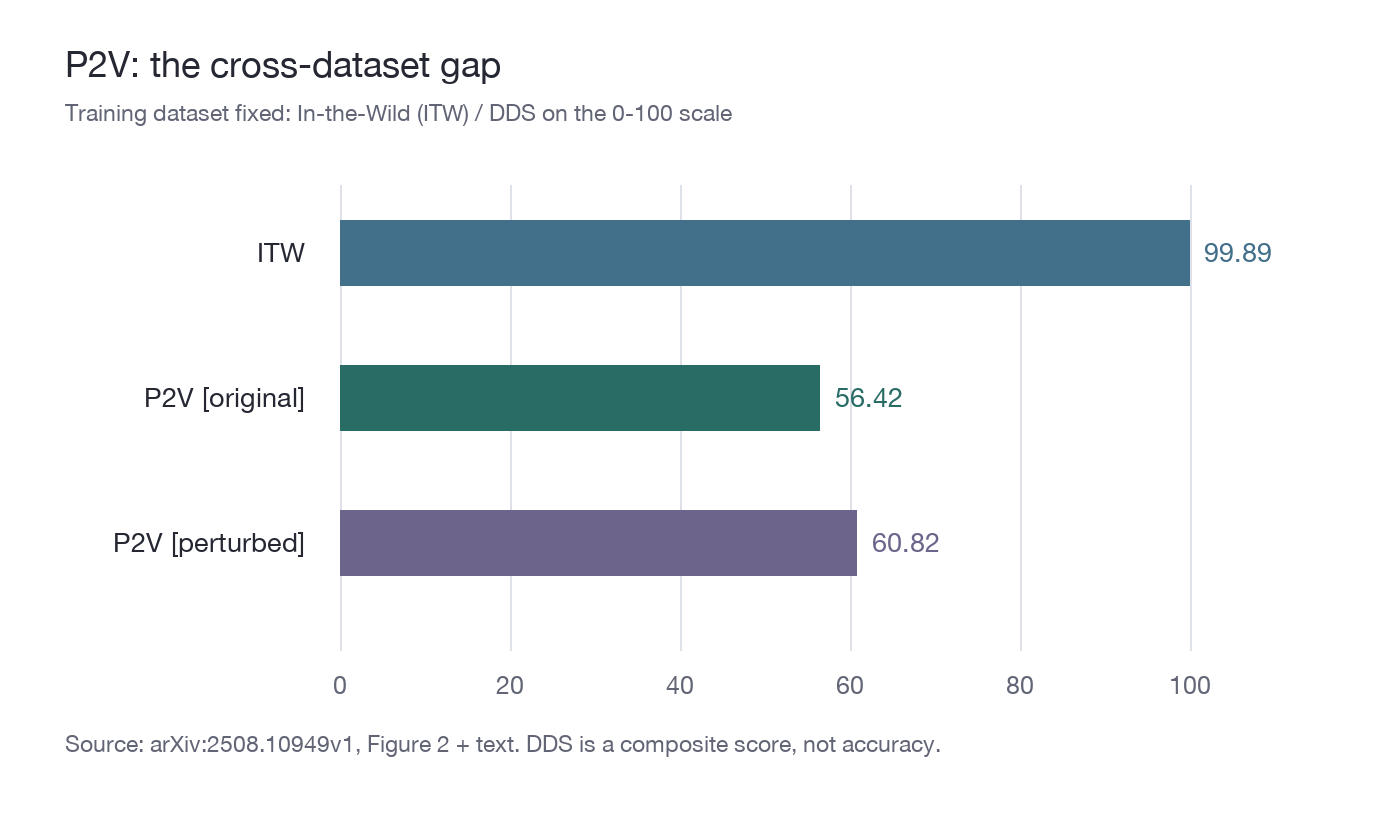
99.89 → 56.42 的差值为 43.47 个 DDS 分数点;相对于 99.89 的降幅约 43.5%。这解释了摘要中“43%”的来源,但它不能等价成所有检测器平均丢失 43 个准确率百分点。
值得注意的是,ITW 训练的模型在扰动版 P²V[p] 上反而比原始版 P²V[o] 得分更高。作者推测 ITW 中已有的噪声与扰动版更接近。这支持一个实用判断:扰动的影响取决于训练分布,不能预设“处理越多越难检测”。
P²V 两种版本训练的模型也能向 ITW 迁移,但 84.42 与 88.96 仍低于 ITW 自身的 99.89。作者报告前两者差异的配对检验 p = 0.39;这只能说明该检验未发现显著差异,不能直接证明两种训练方式完全等效。[原文 Cross-Dataset Evaluations、图 2]
哪些因素更难:噪声与新生成器都需要逐项看
在 ITW 训练、P²V[p] 测试的条件下,表 4 的 DDS 对背景噪声为 44.92,对高斯噪声为 46.82,对 MP3 为 74.53,对带通滤波为 85.08。与全体扰动混合基线 60.82 相比,背景噪声子集低 15.90 分,带通滤波子集反而高 24.26 分。
这里比较的是按扰动类型筛选的不同子集与总体混合基线,不能未经配对分析就把 15.90 分描述为同一段音频添加噪声前后的因果下降。论文把这些结果概括成简单扰动可显著削弱检测,阅读时应保留该分母与比较对象。
合成器也有明显差别:XTTS-v2 的 DDS 为 50.52,IndexTTS 为 52.52,Zonos 为 70.67。Zonos 作为较新的模型却更容易被检测,说明“新模型一定更难”并非普遍规律。正文对 VEVO 的某处数值与表 2 不同,本文如需引用以表 2 的 58.51 为准,不将其与 IndexTTS 的 52.52 混用。
三种台词 LLM 对应的 DDS 为 60.60、61.40 和 60.49,论文未发现这些比较中的显著差异。它支持“在这三个配置和当前指标中没有检测到明显差别”,不等于证明语义内容永远不影响检测。[原文表 2–4]
它更贴近哪些现实问题,又遗漏了什么
- 主要覆盖英语和已故公众人物。不能据此保证对中文、普通用户、口音多样性或在世人物场景同样有效。
- 扰动主要通过数字处理构造。空气吸收和混响模拟不等于在真实空间中完成扬声器回放验证。
- 语义合理性是设计目标之一。仅凭检测结果不能证明生成台词在所有人物与历史语境中都真实可信。
- 高度类别不平衡。需要同时报告真人误报和假音频召回,综合分数不够支撑业务上线。
- 没有完成全面自适应攻击评测。随机后处理的鲁棒性不等价于抵御针对当前检测器优化的扰动。
资源方面,arXiv v1 写明计划在会议或期刊接收后公开数据。本次未从所读论文确认一个官方完整数据下载入口,因此本文不标注为“数据已可直接下载”,也不把第三方索引页当作数据发布证据。
解读观点:P²V 的价值是将跨生成器、跨人物和后处理变化放到可分析的框架中。它补充的是数据覆盖和泛化证据;若要进一步回答安全性,还应加入如 FoeGlass 的生成空间搜索,以及针对训练后模型重新发起的自适应攻击。
原始资料与版本说明
- Perturbed Public Voices (P²V): A Dataset for Robust Audio Deepfake Detection:主要解读版本。方法、表格与局限均以本文标明版本为准。
论文事实、作者解释与本文观点分别表述。图示为原理说明或已公开数值的重绘,不代表新增实验。
相关阅读
这些文章讨论的权限、数据与指标不同,相关阅读用于理解问题之间的联系,不作成功率横向排名。