论文:Can DeepFake Speech be Reliably Detected?
作者:Hongbin Liu、Youzheng Chen、Arun Narayanan、Athula Balachandran、Pedro J. Moreno、Lun Wang
机构:Duke University、Google LLC
版本:arXiv:2410.06572v1,2024-10-09
发表记录:本文按公开 arXiv 版本解读,不据投稿页面推断录用状态
中文原创解读,2026 年 10 月 20 日发布;数值据原论文整理,未独立复现实验。封面使用原论文图;正文结果图按注明来源的数值重绘。
一个语音检测器在标准测试集上几乎不犯错,能不能放心交给用户?《Can DeepFake Speech be Reliably Detected?》给出的回答是:低基准误差并不保证能够抵御有意寻找漏洞的输入。一旦攻击者有模型梯度、查询接口,甚至只有一个替代模型,合成语音的判别结果都可能发生明显变化。
这篇研究由 Duke University 与 Google 的作者完成,以四款开源合成语音检测器为对象,把白盒、黑盒和不查询目标的迁移攻击放在同一研究框架中。它的价值不在于宣布“所有深伪语音永远无法检测”,而在于明确展示:检测可靠性必须与攻击者权限、数据分布和音质要求一起讨论。
先分清:自然域偏移与主动对抗扰动
录音压缩、背景噪声和新一代 TTS 都可能造成测试数据与训练数据不同,这叫域偏移。主动攻击则更进一步:攻击者不满足于随机变化,而是利用反馈,专门寻找能把“合成”推到“真人”一侧的变化。
一个便于理解的例子是:日常路况变化考验车辆对环境的适应,专门设计的障碍则考验系统在最不利条件下的表现。两类测试都重要,但不能用“普通噪声下表现还可以”替代主动攻击评测。
与本站已解读的 FoeGlass 不同,这篇论文主要从已经生成的音频出发,改变波形来绕过检测器;FoeGlass 在 TTS 输入空间搜索新的生成结果。两者暴露的攻击面不同,也没有可直接横向比较的共同成功率。
三种权限,三种不同的可靠性问题
| 设定 | 能访问什么 | 论文采用的方法 | 不能混淆的边界 |
|---|---|---|---|
| 白盒 | 目标模型及梯度 | PGD、I-FGSM | 直接使用目标梯度,条件最有利于攻击者 |
| 黑盒 | 查询目标并观察分数 | SimBA | 仍有目标查询;不是只有最终真假标签 |
| Agnostic / 迁移 | 不查询目标,先攻击另一个模型 | 转移已构造的攻击音频 | 需要替代模型与构造攻击的资源,不是无条件随机噪声 |
攻击方向都是让合成语音被判为真人。白盒部分针对输入音频优化,模型参数不随攻击变化;迁移部分换的是检测器,不能直接解释为跨生成器重新合成仍有同样效果。[原文 §3]
方法拆解:梯度路线与分数路线
白盒:沿着“更像真人”的判别方向移动
设 x 是合成波形,δ 是允许的改动,f 是检测器。目标是让 f(x + δ) 的输出朝真人类别移动。PGD 利用损失的梯度逐步更新扰动,再把扰动投回规定的幅度范围;I-FGSM 使用梯度的符号进行更新。
本文算法中,两者的关键区别就是使用原始梯度还是符号梯度。为了和原文保持一致,不能只凭方法名把论文的实现自动替换成其他攻击库里的默认 PGD。扰动步长、幅度上限和迭代次数也分别控制搜索行为,不能把它们当成同一个“攻击强度”。
合成音频 x → 检测器 f → 朝真人类别的损失
                   ↑              ↓
             新音频 x + δ ← 输入梯度与幅度约束

黑盒路线:试探波形变化 → 查询分数 → 保留有利方向
迁移路线:先在替代检测器完成攻击 → 直接测试目标检测器
黑盒 SimBA:用反馈决定保留哪一步
SimBA 在波形的一组时间位置上尝试变化,观察目标分数是否改善;若当前方向没有帮助,再尝试相反方向。它不需要知道模型权重,但仍依赖反复查询和分数反馈。论文比较了每次修改的维度数、步长以及查询预算,图中查询预算延伸到数千次。
这使得“黑盒有效”具有条件:如果实际系统限频、隐藏分数、改变前处理或对异常查询作处理,论文的离线成功率不能原封不动套用。反过来,只隐藏权重也不能被当作可靠性的充分保证。
阅读校注:算法 2 在循环变量、预算符号和接受步骤的伪代码上存在不够清晰之处。本文解释的是正文描述的分数反馈搜索,不把伪代码直接作为可运行实现;复现应核对实际更新与查询计数。 [原文 §3.2–3.3、算法 1–2]
实验从哪里开始:四个检测器,每个数据集抽取 100 条
作者从头训练 AASIST、AASIST-L、RawNet2 和 RawGATST,训练数据是 ASVspoof2019-LA 的训练划分。它们在同数据集测试划分上的无攻击 EER 如下:
| 模型 | 无攻击 EER ↓ |
|---|---|
| AASIST | 0.83% |
| AASIST-L | 0.99% |
| RawNet2 | 4.88% |
| RawGATST | 3.29% |
这些数值说明训练得到的检测器在标准基准上具有竞争力,不是攻击后的漏检率。EER 是假接受率与假拒绝率相等处的误差,攻击成功率则是在某个判决设定下统计攻击样本绕过检测器的比例,二者不能相减后当作性能下降。
攻击测试来自 ASVspoof2019-LA、WaveFake 与 In-the-wild,因计算预算限制,每个数据集随机抽取 100 条合成音频。论文用被攻击样本中绕过检测器的比例作为成功率。因此这些结果来自选定子集,不能视为全量数据集重测;原文也未在此处清晰说明是否一律先剔除了攻击前已误判的样本。严格复现时应额外报告初始漏检和条件攻击成功率。
音频保真度用 VisQOL 与人工相似性评价检查。它们对理解攻击代价很有用,但不等于已经完成“人类永远听不出来”的证明。[原文 §3.1、表 1]
结果:低 EER 的模型,也可能在主动攻击下失守
白盒:域外数据上的高成功率尤其突出
作者对图 1 的分析指出,在 WaveFake 与 In-the-wild 条件下,PGD 的成功率在所测步长范围内大多接近 100%;ASVspoof2019-LA 条件则随步长在约 60%–100% 之间变化。这是所测四个模型、抽样数据和超参数范围内的观察,不是对任意检测器的保证。
步长增大会影响 VisQOL,说明攻击效果和音质之间存在取舍。论文指出在所测配置中,约 50 次迭代后即可达到较高或趋于稳定的攻击效果;这不能泛化成所有音频、所有约束下 50 步都足够。
黑盒:不用梯度,仍然可能找到绕过方向
正文对图 7 的解读是:在 ASVspoof2019-LA 上,RawNet2 可被接近 100% 地绕过,其他三款约在 60% 左右;在 WaveFake 和 In-the-wild 上,所测模型在该设置下超过 90%。这些概述来自对应图的参数扫描,应避免脱离查询预算,写成一个不带条件的统一数字。
AASIST-L 在多项黑盒实验中表现较稳健,但“它更小,所以一定更鲁棒”并没有被严格证明。模型容量、训练效果与决策边界都可能影响观察到的差别;作者关于更平滑边界的解释属于可能机制。
人工评价:相似的声音,不代表相同的检测结论
以 PGD 为例,表 2 中 AASIST 的人工说话人相似性评分分别为 0.970 ± 0.063、0.971 ± 0.046、0.985 ± 0.030,依次对应三个数据集。这些数字支持攻击前后仍保持较高说话人相似性,不能直接改写成“97% 的人完全听不出差别”,也不能替代内容可懂度、自然度或身份验证的全部维度。
v1 校注:黑盒人工评分表 4 与 I-FGSM 的表 3 数值完全重复,文中没有解释原因。因此本文不把它们当作两份独立证据叠加计算,也不从这两张表推导额外统计结论。 [原文 §3.2–3.3、图 1–9、表 2–4]
不查询目标,也不等于目标安全
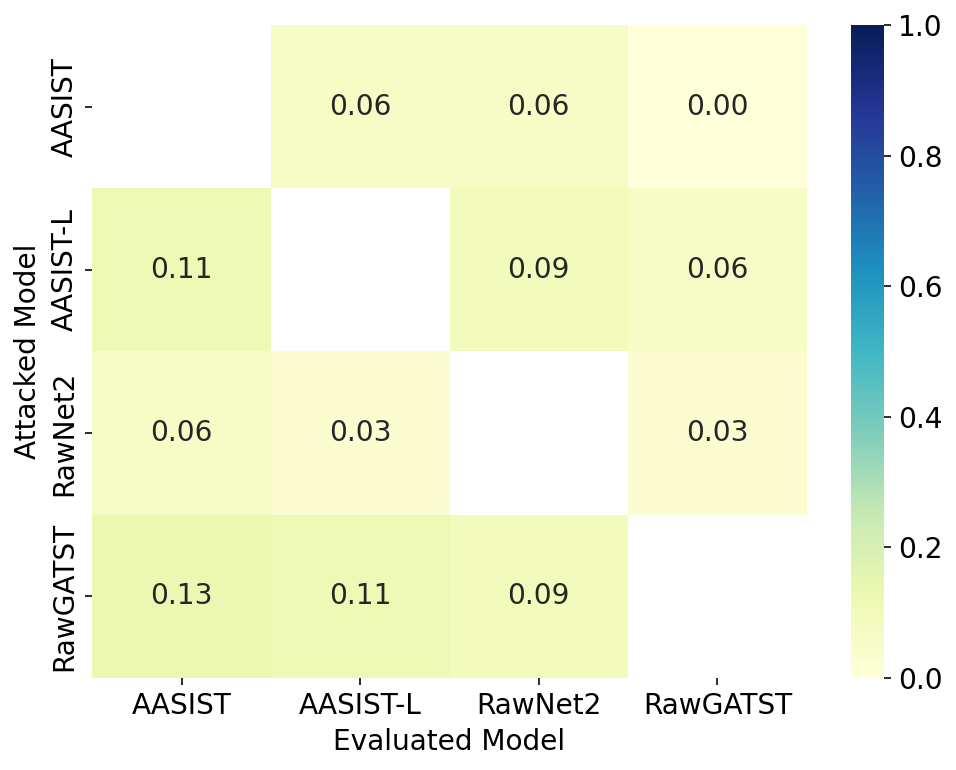
迁移实验先对一个模型构造成功音频,再交给另一个模型判断。图 10 显示,迁移性与源模型、目标模型以及数据集都有关。域外数据上的原本薄弱之处会影响攻击后的表现;在域内测试上,SimBA 的迁移强度与白盒攻击也可能不同。
这说明一个实际问题:如果检测器之间共享某些脆弱特征,阻断目标查询未必能完全消除风险。但它也没有证明迁移是无损的,更没有证明对某个替代模型成功,就必然对商用检测器成功。
作者认为黑盒攻击可能产生更大的扰动,从而解释部分迁移现象;这与“迁移率更高”之间仍需要结合扰动幅度公平比较。迁移成功率、音质代价和目标初始误判都应同时报告。[原文 §3.4、图 10]
这篇论文没有证明什么
- 没有证明检测任务在原理上不可能。研究评估的是四款检测器与给定训练、攻击条件。
- 没有验证物理回放或真实电话攻击。实验主要是数字音频上的离线扰动与分类;现实链路可能改变攻击和音质。
- 没有用一次子集实验覆盖所有合成器。“未见 TTS 更困难”是本文条件下的趋势,而非所有新旧生成器的固定规律。
- 没有充分刻画人类感知的所有维度。人工相似性与客观质量指标是局部证据,评价程序与样本规模仍需核对。
- 没有提供已验证的万能防御。限频、更新训练数据与水印等是讨论方向,不能算作本文完成的防御基准。
解读观点:可靠的语音检测评测至少要同时回答四个问题:在什么分布上有效、攻击者有哪些权限、攻击需要多少预算、付出了多少音质代价。只给一个干净数据 EER,会隐藏这四个维度中的大部分信息。
截至本次查阅,本文以公开 arXiv v1 为解读依据,未在所读原文中找到可确认的官方攻击实现入口,也未据未定稿的会议投稿页面推断录用状态。本文未独立复现实验。
原始资料与版本说明
- Can DeepFake Speech be Reliably Detected?:主要解读版本。方法、表格与局限均以本文标明版本为准。
论文事实、作者解释与本文观点分别表述。图示为原理说明或已公开数值的重绘,不代表新增实验。
相关阅读
这些文章讨论的权限、数据与指标不同,相关阅读用于理解问题之间的联系,不作成功率横向排名。